
StackFlow AI Platform
モデルライブラリ
開発例
LLM630 Compute Kit
StackFlow AI プラットフォーム
StackFlow は、エッジコンピューティングデバイス上で動作するローカル AI サービスプラットフォームです。大規模言語モデル、マルチモーダル、コンピュータビジョン、音声認識、音声合成などの機能をソフトウェアパッケージとして提供し、統一されたサービス呼び出し方式を備えています。
利用の流れ
- デバイスを準備する:ハードウェア接続、ネットワーク設定、必要なシステムやドライバのインストールを完了し、デバイスが正常に動作してターミナルへアクセスできることを確認します。
- StackFlow をインストールまたは更新する:デバイス別のガイドに従って適切なパッケージリポジトリを設定し、StackFlow の基本パッケージをインストールまたは更新します。出荷時にインストール済みのデバイスでは、必要に応じて更新のみを行います。
- AI 機能を選択してインストールする:用途に応じてモデルの種類を選び、対応する機能サービスとデバイスプラットフォームに適合したモデルパッケージをインストールします。
- 実行して呼び出す:モデルのドキュメントと開発例を参照してサービスを起動し、適切なインターフェースを使ってローカル AI 機能をアプリケーションに組み込みます。
StackFlow のインストール
デバイスによってシステム環境やコンピューティングプラットフォームが異なるため、パッケージリポジトリ、インストールコマンド、プリインストール状況も異なる場合があります。使用するデバイスを選択し、対応するインストールまたは更新ガイドを開いてください。

呼び出し方式
StackFlow API
StackFlow API は JSON メッセージを使用して、LLM、VLM、音声、コンピュータビジョンなどの機能サービスを設定および呼び出します。JSON メッセージは UART または TCP で転送でき、使用する通信インターフェースはデバイスによって異なります。
| デバイス | 通信方式 | 主な用途 |
|---|---|---|
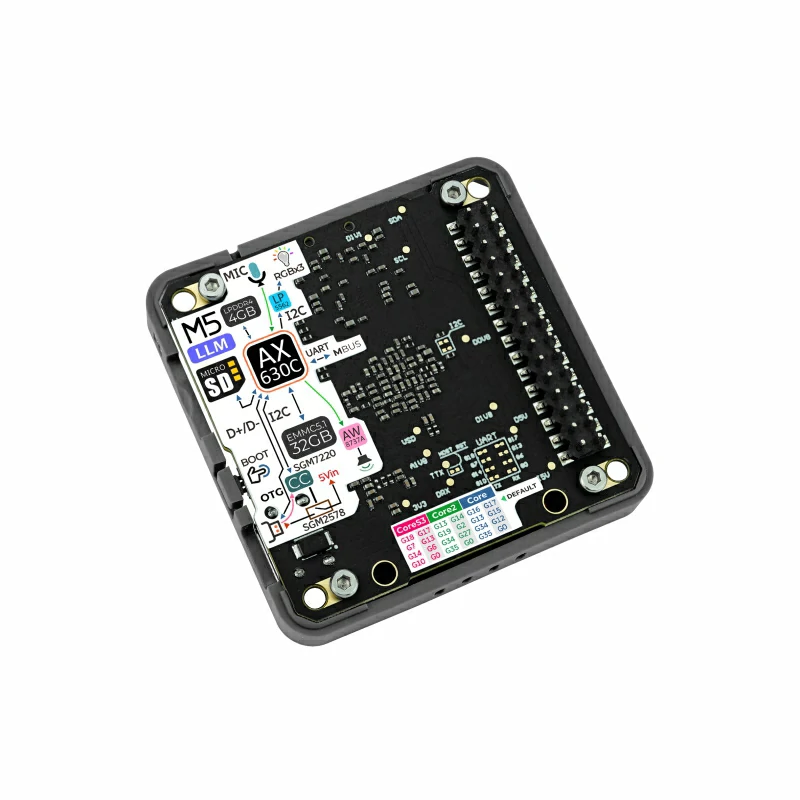
| Module LLM | UART、既定値 115200bps 8N1 | Core、Arduino、またはその他のホストから JSON コマンドを直接送信 |
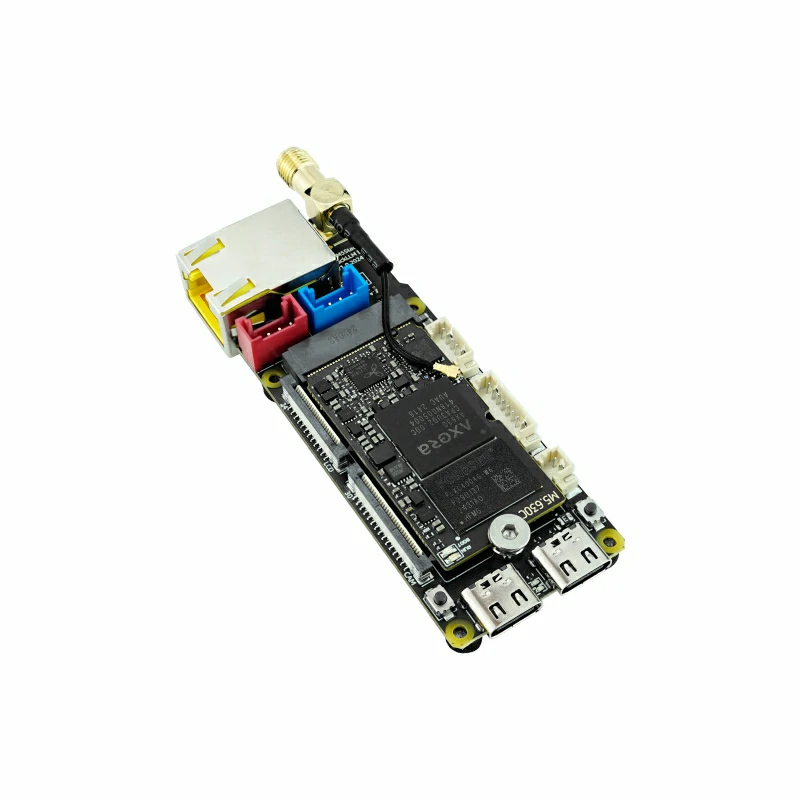
| LLM630 Compute Kit | TCP、既定のポート 10001 | PC または同一ネットワーク上のデバイスから Socket 経由で JSON コマンドを送信 |
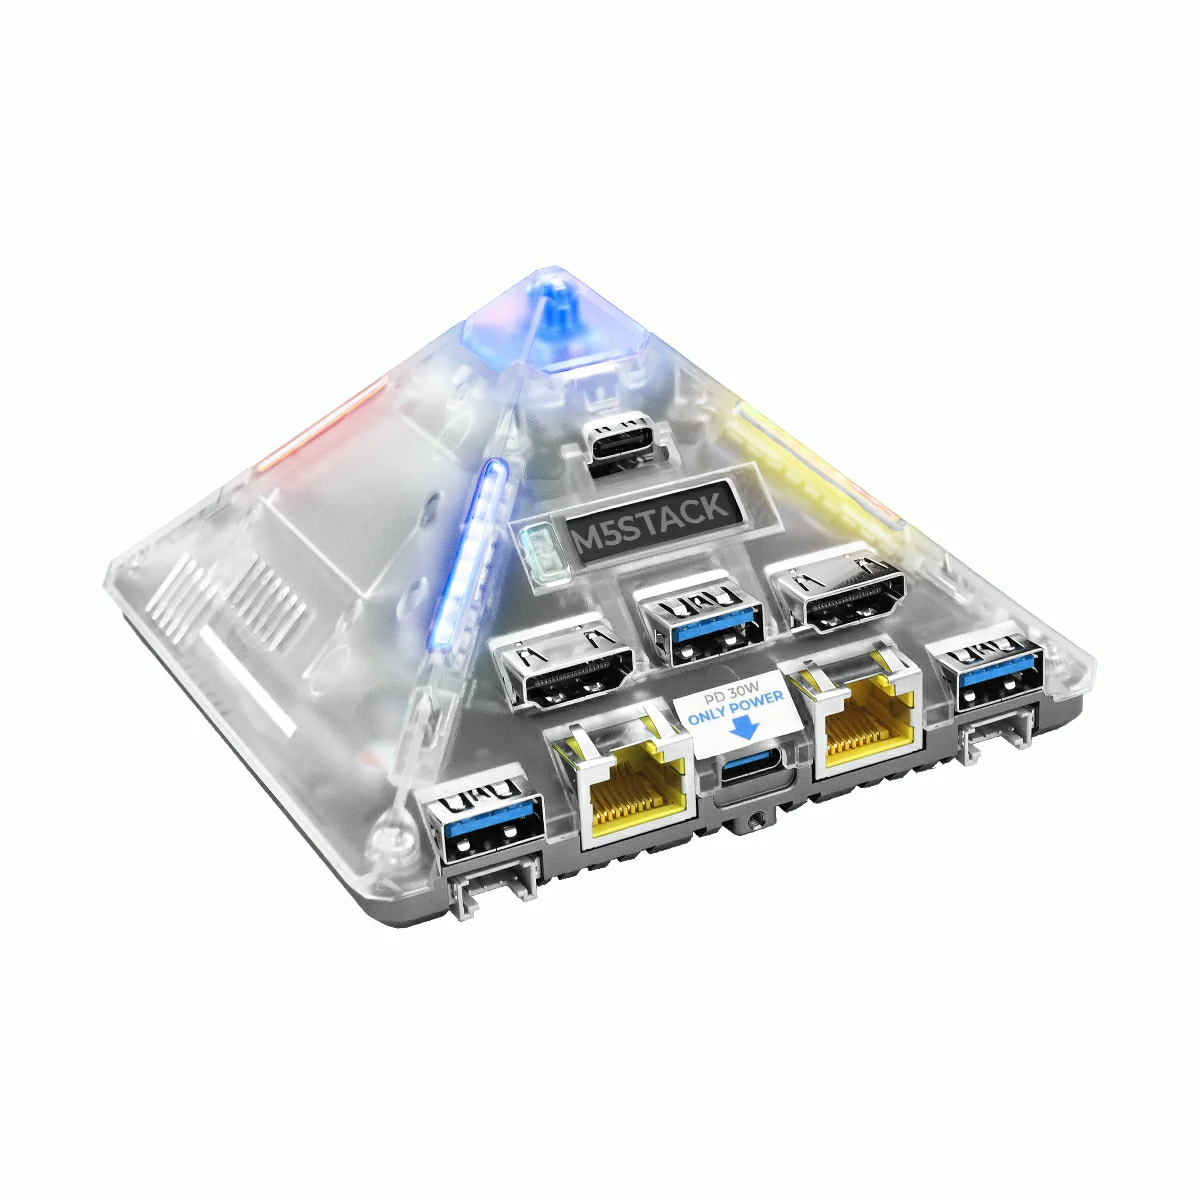
| AI Pyramid | TCP、既定のポート 10001 | デバイス上のアプリケーションまたはネットワーククライアントから Socket 経由で JSON コマンドを送信 |
UART と TCP のどちらを使用する場合も、呼び出しは JSON メッセージで行います。たとえば、クライアントは action と object で操作を指定し、data にモデルと実行時パラメータを渡します。
{
  "request_id": "llm_001",
  "work_id": "llm",
  "action": "setup",
  "object": "llm.setup",
  "data": {
    "model": "qwen2.5-0.5B-prefill-20e"
  }
}初期化後、クライアントは推論データを継続して送信し、返された work_id で対応するタスクを識別できます。関連ドキュメント:
OpenAI 互換 API
llm-openai-api をインストールすると、OpenAI API 形式と互換性のあるローカル HTTP インターフェースがデバイス上で提供されます。OpenAI SDK や Chatbox などの既存クライアントは、通常、サービスの接続先をデバイスの IP アドレスへ変更することで、デバイス上で動作するモデルを呼び出せます。
ここでいう「OpenAI 互換」とは API 形式の互換性を指します。モデルが OpenAI のクラウド上で動作するわけではなく、推論リクエストはローカルデバイスで処理されます。
モデルライブラリ
モデルの機能別に、インストール要件、呼び出し方式、対応ハードウェアプラットフォームを確認できます。
開発例
サンプルページは特定のデバイスで検証されている場合があります。他のデバイスで実行できるかどうかは、そのプラットフォーム向けの機能サービスとモデルパッケージが提供されているかによって決まります。